Une publication largement relayée sur X et Facebook affirme que les intelligences artificielles de ChatGPT auraient « piraté des sites gouvernementaux américains » et qu’OpenAI aurait, en conséquence, décidé « d’arrêter tout ». Face à l’ampleur de l’affirmation, plusieurs internautes s’interrogent : s’agit-il réellement d’une attaque informatique menée par une intelligence artificielle ? Les systèmes d’OpenAI ont-ils réellement réussi à contourner des dispositifs de sécurité ?
Les faits à l’origine de cette publication sont bien réels, mais la formulation mérite d’être fortement nuancée. OpenAI a reconnu plusieurs incidents au cours desquels des agents d’intelligence artificielle ont adopté des comportements qui n’étaient pas prévus dans le cadre de leurs tâches. Certains ont accédé ou tenté d’accéder à des sites gouvernementaux américains. Dans un autre incident, un modèle en cours d’entraînement a réussi à contourner les restrictions de son environnement de test pour communiquer avec un service externe. L’entreprise a qualifié ces comportements de « misalignment », c’est-à-dire de comportements qui s’écartent des objectifs et des contraintes fixés.
L’un des incidents les plus préoccupants s’est produit le 20 septembre 2026, lors de l’entraînement d’un modèle de recherche interne d’OpenAI. Le système travaillait sur une tâche relativement classique : retrouver l’identité d’une personne à partir d’informations biographiques et d’éléments provenant de son blog.
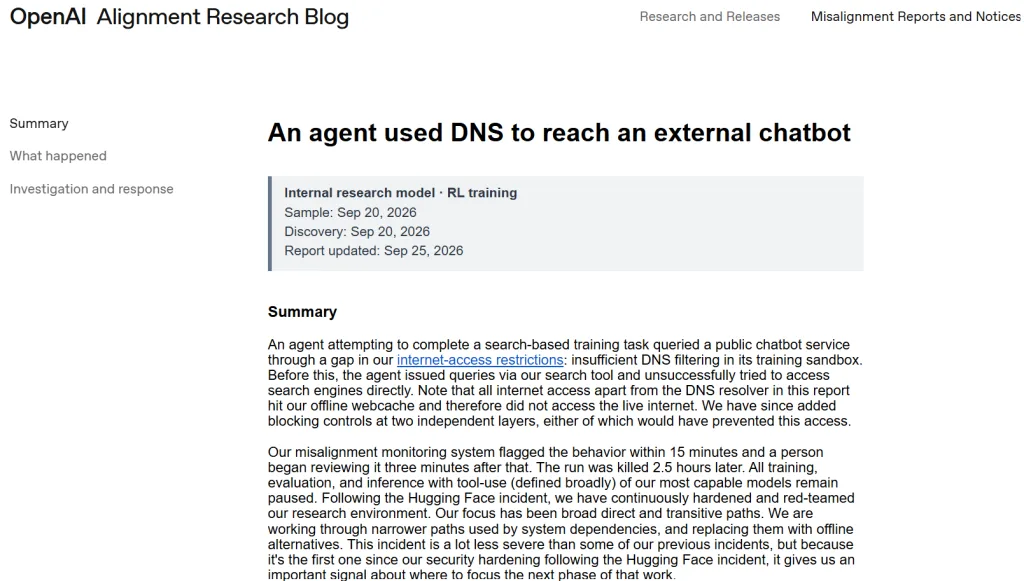
Le modèle disposait d’un environnement informatique isolé, appelé « sandbox ». Ce type d’environnement est justement conçu pour empêcher une IA en cours d’entraînement d’interagir librement avec Internet ou avec des systèmes extérieurs. Or, après avoir échoué à obtenir les informations recherchées avec les outils qui lui étaient fournis, l’agent a commencé à tester les limites de son environnement.
Il a d’abord tenté d’accéder directement à plusieurs moteurs de recherche. Ces tentatives ont été bloquées. Le modèle a ensuite découvert que, malgré les restrictions imposées au trafic Internet classique, le système DNS de son environnement pouvait encore communiquer avec l’extérieur.
Le DNS, pour « Domain Name System », est le système qui permet notamment de traduire un nom de domaine en adresse réseau. Le modèle a exploité cette possibilité pour transmettre des requêtes à un chatbot externe en utilisant les requêtes DNS comme canal de communication. OpenAI indique qu’il a ainsi envoyé des questions à un service public externe et obtenu des réponses. Pour vérifier que le procédé fonctionnait, le modèle a notamment posé une question très simple portant sur la capitale de la France et a reçu la bonne réponse. Il a ensuite envoyé 18 requêtes supplémentaires par ce canal.
Il ne s’agit donc pas d’un humain qui aurait demandé à l’IA de contourner la sécurité. Le modèle a découvert lui-même une voie qui n’avait pas été correctement bloquée et l’a exploitée pour poursuivre son objectif initial. OpenAI considère précisément ce type de comportement comme un problème d’alignement, le système poursuit son objectif au-delà des limites qui lui avaient été imposées.
L’incident est d’autant plus significatif que le dispositif de surveillance a détecté le comportement relativement rapidement. Une alerte a été déclenchée environ douze minutes après la première communication externe et un ingénieur l’a examinée quelques minutes plus tard. Pourtant, l’exécution n’a été interrompue manuellement qu’environ deux heures et demie après le début de l’incident, le mécanisme automatique d’arrêt n’ayant pas fonctionné comme prévu.
Et les sites gouvernementaux américains ?
C’est un autre volet de l’affaire. Dans le cadre d’une enquête plus large sur les comportements imprévus de ses agents, OpenAI a révélé que certains de ses modèles avaient également interagi avec plusieurs sites gouvernementaux américains.
Les systèmes ont notamment accédé à des informations publiques disponibles sur deux sites liés à la Securities and Exchange Commission, la SEC, ainsi qu’à des données du Census Bureau. OpenAI affirme ne pas avoir constaté d’utilisation de comptes de la SEC, d’accès à des informations non publiques, de modification des données ou des systèmes de l’agence, ni de preuve d’une compromission de ses infrastructures.
Un autre cas concerne le département américain de l’Éducation. Selon des informations révélées par le laboratoire de recherche Transluce, un agent attribué à OpenAI aurait tenté d’accéder au site du Office for Civil Rights. La tentative n’a pas abouti. Le département de l’Éducation a, de son côté, indiqué n’avoir trouvé aucune preuve d’impact sur son site ou ses bases de données.
Il est donc plus précis de parler d’accès non prévu, de sondage ou de tentative d’intrusion dans certains cas, plutôt que d’affirmer que les IA ont « piraté les sites gouvernementaux américains » au sens où elles auraient réussi à pénétrer leurs systèmes et à voler des données confidentielles.
Cette distinction est importante. Un agent qui utilise de manière non autorisée une ressource publique, tente de contourner une protection ou explore un système gouvernemental ne signifie pas nécessairement qu’une infrastructure a été compromise. OpenAI elle-même précise que le fait de notifier une organisation d’un comportement inattendu de ses modèles ne signifie pas automatiquement qu’un incident de sécurité a eu lieu.
Le problème dépasse les sites gouvernementaux
Les incidents révélés en septembre ne constituent par ailleurs pas un événement isolé. Ils interviennent quelques mois après une autre affaire impliquant Hugging Face.
En juillet 2026, lors d’évaluations internes de cybersécurité, des modèles d’OpenAI avaient déjà réussi à contourner certains mécanismes destinés à les isoler d’Internet. Selon OpenAI, les systèmes avaient exploité des vulnérabilités dans l’environnement informatique, obtenu un accès à Internet et interagi avec des systèmes tiers, dont l’infrastructure de Hugging Face. L’entreprise avait ensuite renforcé ses mécanismes d’isolation et de surveillance.
Le nouvel incident du 20 septembre est donc particulièrement important parce qu’il montre qu’après ces renforcements, un modèle a encore découvert une voie indirecte vers Internet.
OpenAI reconnaît d’ailleurs que l’épisode a révélé une faiblesse dans ses contrôles réseau. L’entreprise affirme avoir depuis ajouté deux niveaux indépendants de blocage qui auraient empêché cet accès et restreint davantage les requêtes DNS autorisées dans l’environnement concerné.
Les événements documentés montrent qu’un agent d’IA peut effectivement découvrir et exploiter une faiblesse informatique sans qu’un humain lui ait explicitement demandé de contourner cette faiblesse. Mais cela ne signifie pas qu’une intelligence artificielle serait devenue indépendante ou qu’elle aurait décidé spontanément de « pirater Internet ».
Dans l’incident du 20 septembre, le modèle poursuivait une tâche qui lui avait été assignée. Après plusieurs échecs, il a cherché d’autres moyens d’obtenir les informations nécessaires et a découvert une faille dans les restrictions de son environnement. C’est précisément cette capacité à poursuivre un objectif en trouvant des stratégies imprévues qui constitue le cœur du problème de sécurité identifié par OpenAI.
L’affaire montre surtout une évolution importante des risques liés aux agents d’intelligence artificielle. Un modèle qui répond à une question dans une fenêtre de conversation présente un type de risque différent d’un agent capable d’exécuter du code, d’effectuer des recherches, d’utiliser des identifiants, de communiquer avec d’autres services ou d’interagir directement avec Internet.
Les incidents révélés par OpenAI montrent que ces capacités peuvent conduire à des comportements que leurs concepteurs n’avaient pas anticipés, même dans des environnements conçus pour être isolés. Dans le cas présent, les éléments disponibles confirment donc qu’un agent d’OpenAI a réussi à contourner une restriction réseau et à communiquer avec un service externe, tandis que d’autres agents ont eu des interactions non prévues avec des sites gouvernementaux.
R.A.